Metodi sicuri, opzioni proxy e workflow pratico con BitBrowser
 2026.08.27 15:29
 petro
Google Maps è una risorsa centrale per chi lavora con attività locali, ricerche di mercato, sviluppo di applicazioni e SEO locale. È quindi normale trovare ricerche come “Google Maps scraping”. Tuttavia questa espressione può indicare procedure molto diverse: utilizzare le API ufficiali, effettuare verifiche manuali nell’interfaccia oppure automatizzare la copia massiva di contenuti in un database esterno.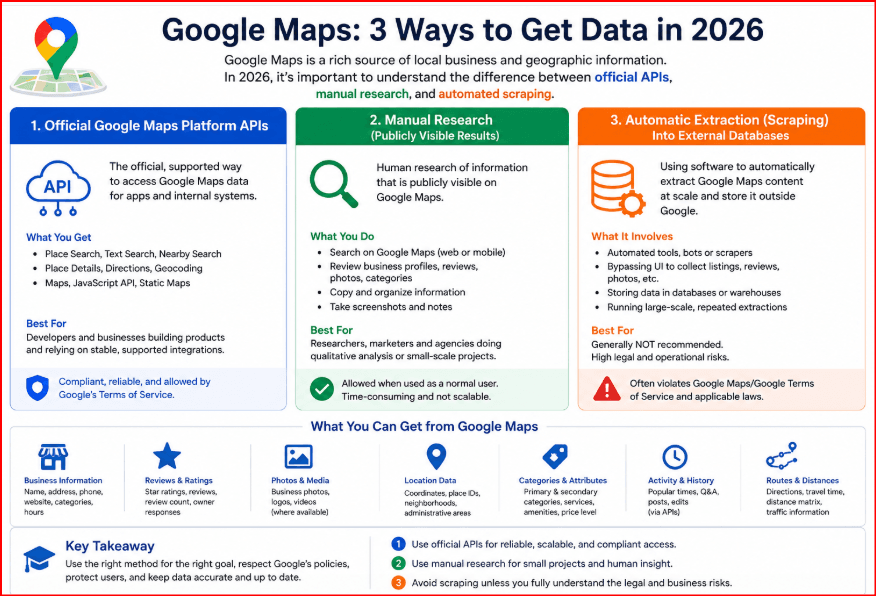
Nel 2026 la distinzione è fondamentale. I termini attuali di Google Maps Platform vietano di esportare, estrarre o fare scraping di Google Maps Content per usarlo fuori dai Servizi e citano, tra gli esempi, il download massivo di informazioni sui luoghi e il salvataggio di nomi, indirizzi o recensioni. Un progetto professionale dovrebbe quindi partire dallo scopo e dalla licenza dei dati, non dal numero di browser o proxy disponibili.
Nota di conformità: Google Maps Platform vieta attualmente lo scraping di Google Maps Content per uso esterno ai Servizi. Questa guida tratta Places API, dati con licenza e QA controllato. Non usare BitBrowser o proxy per aggirare CAPTCHA, quote o controlli. |
Confronto dei metodi
Metodo | Ideale per | Storage/diritti | Rischio |
|---|---|---|---|
Places API | App e ricerca autorizzata | Secondo policy API | Costo e quote |
QA manuale | Controlli visivi/locali | Note consentite | Campione ridotto |
Dataset con licenza | Analisi persistente ampia | Secondo licenza | Costo/freschezza |
Bot sulla UI | Non consigliato | Conflitto con no-scraping | Blocchi e diritti |
Cosa si intende davvero per Google Maps scraping
Di solito si vogliono raccogliere nome dell’attività, categoria, indirizzo, telefono, sito web, rating, numero di recensioni, orari, coordinate o place_id. L’obiettivo può essere un audit SEO, una ricerca competitiva o un controllo di localizzazione. Una piccola osservazione manuale è però diversa da un crawler che memorizza migliaia di schede.
Prima di scegliere uno strumento, definisci campi, fonte e regole di conservazione. Per funzioni applicative usa Places API quando appropriato. Per dataset persistenti valuta un provider con licenza. Per QA geografico può essere utile un profilo browser controllato.
I termini di Google Maps come requisito di progetto
I termini di Google Maps Platform includono una clausola No Scraping che vieta l’estrazione di Google Maps Content per uso esterno. Le policy di Places API aggiungono regole su attribuzione, caching e storage. Il place_id ha un trattamento particolare, ma non bisogna assumere che tutti i campi siano liberamente memorizzabili.
Le regole possono cambiare in base al servizio e alla regione di fatturazione. Per questo conviene registrare provenienza, data di raccolta, retention e obblighi di attribuzione. In un progetto con più fonti, questa disciplina evita di confondere osservazioni manuali con dati API.
Places API e fonti con licenza
Places API offre una via strutturata e documentata per molte ricerche su luoghi. Autenticazione, quote, billing e risposte strutturate rendono il sistema più prevedibile rispetto al parsing dell’interfaccia consumer.
Se il progetto richiede un archivio di milioni di aziende, dati storici o redistribuzione, la soluzione migliore può essere un fornitore di business data con licenza adeguata. L’API ufficiale va usata rispettando i suoi limiti, non come scorciatoia per creare un clone permanente di Maps.
Schema dati prima del codice
Una tabella per la ricerca locale può contenere query, città, data, nome attività, categoria, sito, telefono, rating, numero di recensioni, stato di apertura, place_id dove consentito, fonte e note. Aggiungi sempre la provenienza.
Uno schema ristretto riduce costi, duplicati e raccolta inutile. Rende inoltre più semplice spiegare perché ogni campo è presente nel report e applicare regole di conservazione differenti in base alla fonte.
Come usare BitBrowser per ricerca e QA su Google Maps
BitBrowser può organizzare profili separati per cliente, mercato o città. Ogni profilo mantiene sessione, cookie e local storage isolati e può usare un proxy HTTP, HTTPS o SOCKS5 autorizzato. Questo è utile per verificare scenari regionali in modo ripetibile.
Crea per esempio “Maps QA - Milano” e “Maps QA - Parigi”, verifica l’IP prima del test e mantieni lo stesso endpoint durante il confronto. Lo scopo è controllare la localizzazione e la presentazione, non ruotare identità per superare protezioni.
Passo | Azione BitBrowser | Scopo |
|---|---|---|
1 | Creare profilo nominato | Separare cliente/mercato |
2 | Aggiungere proxy approvato | Impostare regione rete |
3 | Controllare proxy | Confermare IP |
4 | Allineare lingua/fuso | Coerenza test |
5 | Aprire Maps e query fisse | Confrontare osservazioni |
6 | Tenere endpoint stabile | Ridurre rumore |
7 | Places API per dati programmatici | Separare QA e acquisizione |
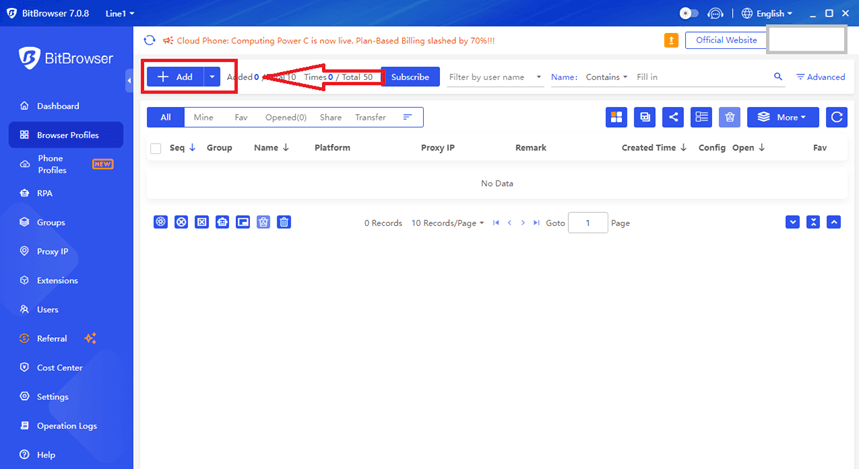
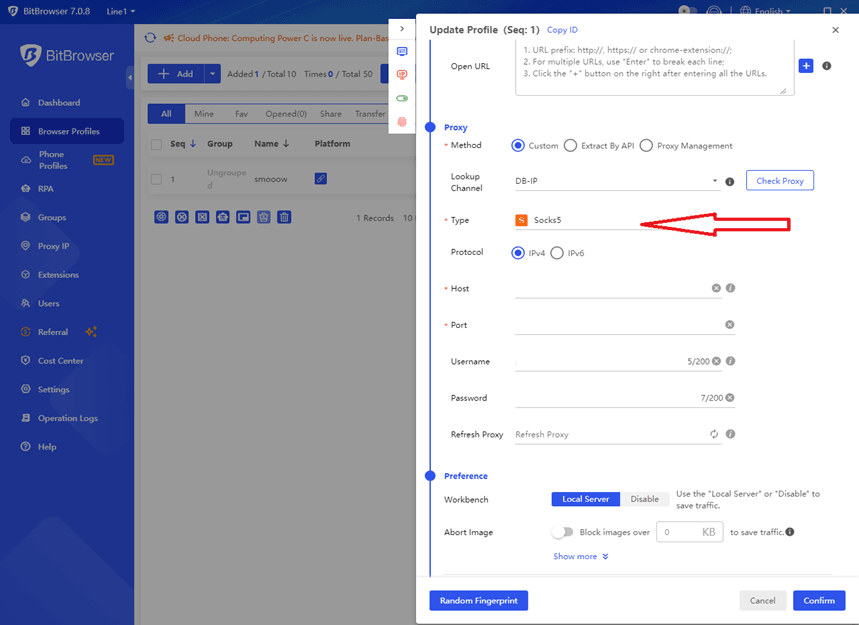
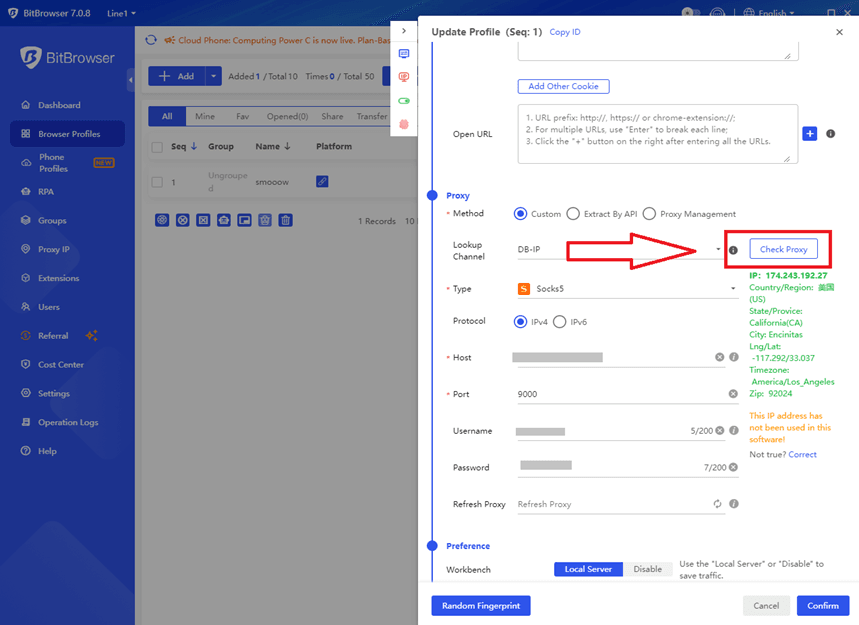
Workflow BitBrowser passo per passo
1. Crea un nuovo profilo e assegnagli un nome chiaro. 2. Configura il proxy approvato se serve un’uscita di rete regionale. 3. Controlla IP e disponibilità. 4. Allinea lingua e fuso orario con lo scenario di test.
5. Apri Google Maps e ripeti query documentate. 6. Registra solo osservazioni necessarie. 7. Per i dati programmatici usa Places API o un dataset con licenza. Non utilizzare rotazioni IP per aggirare CAPTCHA, quote o blocchi.
Il ruolo corretto dei proxy
Un proxy è utile per QA geografico, localizzazione e verifica di esperienze regionali. Un endpoint stabile permette a un team di riprodurre lo stesso scenario e confrontare risultati nel tempo.
Non modifica però i diritti sul contenuto. Se l’automazione incontra limiti, la risposta corretta è rivalutare metodo, API e licenza. Aumentare la rotazione può rendere il test meno coerente e non risolve la questione delle condizioni d’uso.
SEO locale
Per un audit SEO puoi osservare composizione dei risultati locali, categorie, orari mostrati, coerenza del sito, rating visibile e numero di recensioni. Integra queste osservazioni con Google Business Profile, Search Console, analytics, CRM e strumenti di ranking autorizzati.
La combinazione di fonti consente di collegare visibilità e conversioni, evitando di trasformare Maps in un database copiato. In questo modo il team misura il valore del posizionamento, non solo l’aspetto della SERP locale.
Ricerca di mercato e concorrenti
Seleziona un campione di query e quartieri invece di tentare di acquisire un’intera città. Una buona campionatura può mostrare densità competitiva, categorie e modelli di presenza online.
Per analisi su decine di migliaia di imprese, un provider con licenza è più sostenibile di un crawler fragile. La licenza chiarisce inoltre quali dati possono essere conservati, trasformati e utilizzati nei report.
Qualità e deduplicazione
Nomi, telefoni e domini presentano varianti. Normalizza i valori ma conserva il dato originale. Non unire due record solo perché il nome è simile.
Usa indirizzo, dominio, telefono e identificatori consentiti. Registra le regole di merge affinché l’analisi sia verificabile. Un audit trail è essenziale quando una decisione di deduplica deve essere rivista.
Architettura responsabile
Separare acquisizione, normalizzazione, storage e analisi rende il progetto più solido. Le fonti possono includere API, dati del cliente, provider con licenza e osservazioni manuali limitate. BitBrowser appartiene soprattutto al livello di QA.
In questo modo le modifiche dell’interfaccia non distruggono la pipeline e ogni fonte mantiene le proprie regole di retention. L’analisi rimane indipendente dallo strumento utilizzato per la visualizzazione.
Quando il browser è migliore di un dataset
Alcune domande sono visive: quali categorie compaiono, se un pulsante è presente, come cambia la pagina con la lingua o se una landing regionale funziona. Un profilo controllato con note o screenshot può essere più utile di una grande estrazione.
BitBrowser aiuta a mantenere stabile il contesto del test. Se profilo, proxy e impostazioni regionali restano coerenti, è più semplice capire se la variazione osservata dipende davvero dal mercato o da una modifica della sessione.
Checklist operativo
Prima di ogni sessione conferma domanda di ricerca, regione, fonte approvata, campi, retention e responsabile. Verifica poi profilo BitBrowser, endpoint e query. Alla fine elimina ciò che non serve e conserva solo i dati che il progetto può mantenere.
Il checklist deve includere anche la data e un riferimento alla fonte. Questo riduce la raccolta indiscriminata e rende l’attività più facile da spiegare a cliente, manager o revisore.
Governance del team
Definisci proprietari, gruppi cliente e naming convention. Non riutilizzare lo stesso profilo per progetti scollegati. Proteggi credenziali proxy e API con il principio del minimo privilegio.
Se un progetto cambia scopo, verifica nuovamente le fonti e le regole prima di estendere la raccolta. Una buona governance evita che un semplice audit browser diventi senza controllo un database permanente.
Errori da evitare
Non automatizzare prima di leggere i termini. Non raccogliere ogni campo solo perché è visibile. Non mescolare API e dati browser senza provenienza. Non trattare un CAPTCHA come un invito a cambiare IP continuamente.
Separa i progetti in profili BitBrowser e limita l’accesso alle sessioni dei clienti. Un profilo isolato migliora l’organizzazione, non rende lecito un uso vietato o una modalità di conservazione non autorizzata.
Scalare con controllo
Inizia con un pilota, misura utilità dei campi, frequenza di aggiornamento e costi. Spesso un campione periodico è sufficiente per la strategia locale.
Per lavori ricorrenti crea una SOP con fonti approvate, retention, account API, profili BitBrowser, regioni, query e procedura quando il sito cambia o blocca. Il processo deve poter essere auditato senza dipendere dalla memoria di un singolo operatore.
Conclusione
Nel 2026 il Google Maps scraping va affrontato soprattutto come problema di diritti, qualità e architettura dei dati. Le condizioni Google limitano scraping e riuso esterno. Places API e fonti con licenza sono quindi fondamentali.
BitBrowser può supportare test regionali controllati con profili e proxy stabili. Il valore è la ripetibilità del QA, non l’elusione dei controlli. Usato correttamente, aiuta a separare progetti e a rendere più coerenti le osservazioni.
Domande frequenti
È consentito fare scraping di Google Maps?
I termini attuali includono un divieto di scraping di Google Maps Content per uso esterno. Verifica sempre la versione vigente.
Posso usare Places API?
Sì, per molti casi è la soluzione programmatica corretta, rispettando attribuzione, storage e utilizzi consentiti.
BitBrowser può automatizzare Maps?
Può gestire profili e automazioni, ma l’automazione deve restare dentro un uso autorizzato.
Posso usare proxy per risultati locali?
Sì per QA legittimo. Mantieni l’endpoint stabile e non usarlo per aggirare limiti.
Quali dati servono per SEO locale?
Solo quelli pertinenti: query, regione, data, identità attività, categoria, sito, rating, review count e note.
Posso salvare place_id?
Google consente la memorizzazione di place_id secondo policy specifiche. Controlla la documentazione aggiornata.
Come gestire dataset enormi?
Usa un provider con licenza che consenta analisi e conservazione su larga scala.
Perché BitBrowser?
Per isolare progetti e mantenere proxy, sessioni e impostazioni regionali coerenti.
Riferimenti ufficiali

 Gestione di account multipli
 Previeni l'associazione degli account
 Gestione multi-impiegato
Articoli Consigliati
vedi di più