Google Maps Scraping em 2026: dados, Places API e fluxo com BitBrowser
 2026.08.27 16:10
 petro
Google Maps é usado por equipes de SEO local, marketing, desenvolvimento e pesquisa de mercado. Por isso “Google Maps scraping” é uma busca comum. O termo, porém, mistura práticas diferentes: usar APIs oficiais, fazer observações manuais no navegador ou automatizar a cópia em massa de conteúdo para uma base externa.
Em 2026, a política precisa vir antes da automação. Os termos atuais do Google Maps Platform proíbem exportar, extrair ou fazer scraping de Google Maps Content para uso fora dos Serviços e citam como exemplos copiar e salvar nomes de empresas, endereços e avaliações. Um projeto profissional deve definir campos, fonte e direitos de armazenamento antes de escolher ferramentas.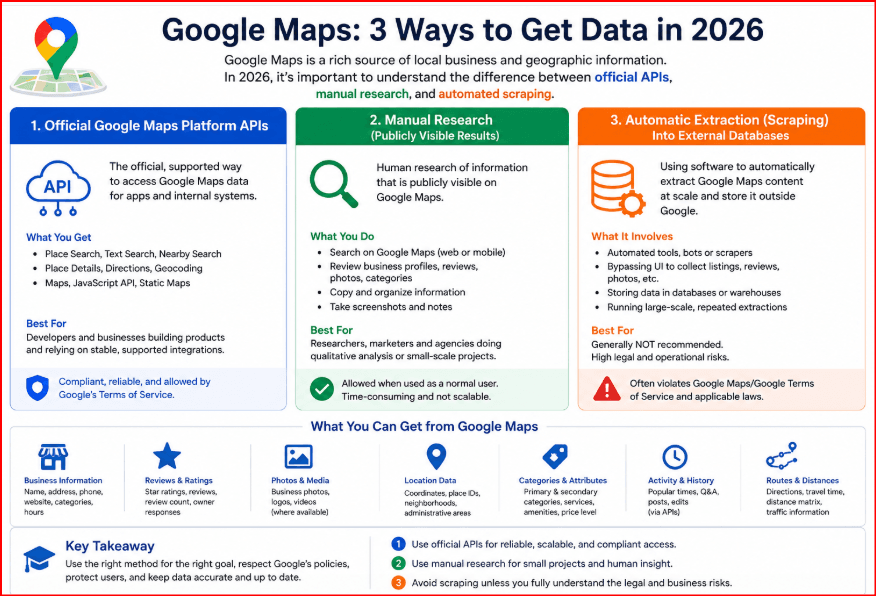
Comparação de métodos
Método | Melhor para | Armazenamento/direitos | Risco |
|---|---|---|---|
Places API | Apps e busca aprovada | Conforme políticas API | Custo/cota |
QA manual | Testes visuais/localização | Notas permitidas | Amostra pequena |
Dataset licenciado | Análise grande persistente | Conforme licença | Custo/atualização |
Bot na UI | Não recomendado | Conflito no-scraping | Bloqueio/direitos |
O que Google Maps scraping normalmente significa
Os campos desejados costumam incluir empresa, categoria, endereço, telefone, site, nota, quantidade de avaliações, horário, coordenadas ou place_id. Uma pequena auditoria manual não equivale a um crawler que armazena milhares de fichas.
Para busca de lugares em aplicações, avalie Places API. Para bases grandes e permanentes, use fonte licenciada. Para verificar resultados locais em outra cidade, um perfil controlado de navegador pode apoiar QA sem transformar a tarefa em coleta massiva.
Termos do Google Maps
Os termos atuais incluem uma restrição No Scraping e as políticas de Places API adicionam regras de atribuição, cache e armazenamento. place_id recebe tratamento específico, mas outros conteúdos não devem ser assumidos como dados livres para armazenamento permanente.
Regras podem variar conforme produto e região de cobrança. Documente origem, data, retenção e atribuição para cada campo, separando claramente API, observação manual e dados de terceiros.
Places API e fontes licenciadas
Places API fornece interface estruturada, autenticação, cotas, cobrança e documentação. É mais sustentável do que depender do HTML de uma interface que muda e facilita monitorar erros e custos.
Para milhões de registros, histórico ou redistribuição, um fornecedor comercial licenciado pode ser mais apropriado. A licença deixa claro se é possível armazenar, transformar e usar os dados em análises.
Defina o esquema de dados
Uma tabela de pesquisa pode ter consulta, cidade, data, empresa, categoria, site, telefone, nota, número de avaliações, status, place_id quando permitido, fonte e notas.
O campo fonte separa API, observação manual e dados licenciados. Um esquema enxuto reduz custo, melhora deduplicação e evita guardar informação que não será usada no relatório.
Como usar BitBrowser para QA no Google Maps
BitBrowser permite separar clientes e regiões em perfis independentes, com cookies e local storage isolados. Cada perfil pode usar proxy HTTP, HTTPS ou SOCKS5 autorizado e configurações regionais coerentes.
Crie, por exemplo, “Maps QA - São Paulo” e “Maps QA - Lisboa”. Verifique IP antes do teste e mantenha o endpoint estável durante a comparação. O objetivo é produzir um cenário repetível, não mascarar automação.
Etapa | Ação BitBrowser | Objetivo |
|---|---|---|
1 | Criar perfil nomeado | Separar cliente/mercado |
2 | Adicionar proxy aprovado | Definir região de rede |
3 | Checar proxy | Confirmar IP |
4 | Alinhar idioma/fuso | Coerência do QA |
5 | Abrir Maps e queries fixas | Observações comparáveis |
6 | Manter endpoint estável | Reduzir ruído |
7 | Places API para dados programáticos | Separar QA de aquisição |
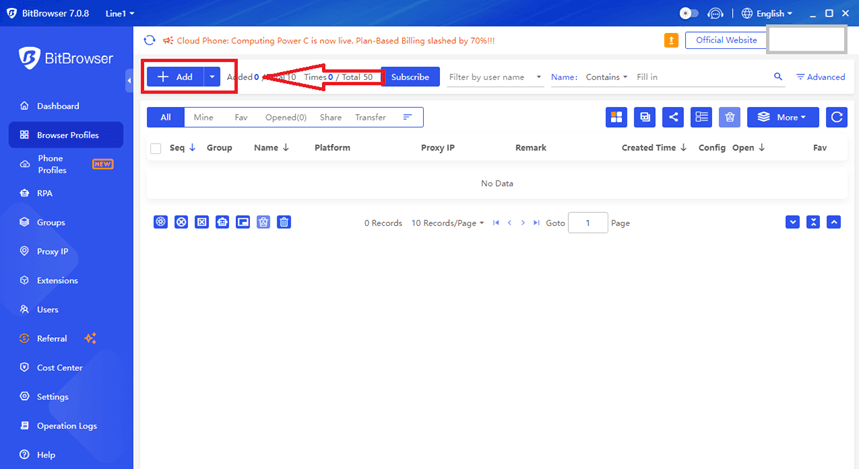
Fluxo BitBrowser passo a passo
1. Crie um perfil com nome claro. 2. Adicione proxy aprovado quando a localização de rede for necessária. 3. Verifique IP e disponibilidade. 4. Ajuste idioma e fuso conforme o cenário.
5. Abra Google Maps e repita as consultas documentadas. 6. Registre apenas as observações necessárias. 7. Para dados programáticos, use Places API ou fonte licenciada. Não use rotação para contornar CAPTCHA ou limites.
O papel dos proxies
Proxy é útil para QA geográfico e localização. Um endpoint estável torna o teste reproduzível entre analistas e ajuda a reduzir diferenças provocadas por mudanças de rede.
Ele não concede direitos adicionais sobre o conteúdo. Bloqueios são um sinal para revisar o método. Mais proxies não resolvem questões de licença ou retenção.
SEO local
Equipes podem observar map pack, categorias, horário, consistência do site, nota e volume visível de avaliações. Combine com Google Business Profile, Search Console, analytics e CRM.
Assim a visibilidade é conectada a conversões reais. O browser mostra o contexto local, enquanto os dados próprios indicam se a presença gera cliques, chamadas e oportunidades.
Mercado e concorrência
Escolha consultas e bairros representativos em vez de tentar copiar uma cidade inteira. Uma amostra bem desenhada costuma ser suficiente para estratégia e permite comparar categorias e densidade competitiva.
Para dezenas de milhares de empresas, use um dataset licenciado. É mais sustentável e define claramente atualização, armazenamento e uso comercial.
Qualidade e deduplicação
Nomes, telefones e domínios variam. Normalize formatos, preserve os valores originais e não una registros apenas por nome semelhante.
Use endereço, telefone, domínio e identificadores permitidos. Registre regras de merge e mantenha um histórico para corrigir combinações incorretas.
Arquitetura responsável
Separe aquisição, normalização, armazenamento e análise. Fontes podem ser API, dados próprios, fornecedores licenciados e observação manual limitada. BitBrowser fica principalmente na camada de QA.
Essa arquitetura reduz dependência da interface e permite retenção específica por fonte. O navegador não deve virar um substituto oculto para um feed autorizado.
Quando o navegador é melhor
Algumas perguntas são visuais: categorias no topo, presença de botão, idioma da interface ou comportamento de landing page regional. Nesses casos perfil controlado, notas e screenshots podem ser mais úteis do que grande extração.
BitBrowser ajuda a repetir esse contexto com o mesmo perfil, proxy e região. Assim a equipe interpreta melhor as mudanças sem aumentar a coleta automática.
Checklist prático
Antes de cada sessão confirme pergunta, região, fonte aprovada, campos, retenção e responsável. Depois valide perfil BitBrowser, endpoint e consultas. Ao final remova observações desnecessárias.
Inclua data e objetivo. Esse registro evita coleta por curiosidade e torna o relatório mais fácil de reproduzir ou auditar depois.
Governança da equipe
Defina donos de perfis, grupos por cliente e padrão de nomes. Não reutilize o mesmo perfil em projetos sem relação. Proteja credenciais de proxy e chaves API com menor privilégio.
Se o escopo mudar, revise fonte e retenção antes de ampliar a coleta. Governança evita que um simples teste visual vire uma base permanente sem planejamento.
Erros comuns
Automatizar antes de ler termos, coletar campos demais, perder proveniência e responder a CAPTCHA com mais rotação de proxy são erros recorrentes.
Mantenha projetos autorizados em perfis BitBrowser separados e controle o acesso às sessões. Isolamento melhora o processo, mas não altera os direitos sobre o conteúdo.
Escala com controle
Comece com piloto, valide os campos, frequência e custo de API ou licença. Muitas análises locais funcionam com amostragem periódica.
Crie uma SOP com fontes aprovadas, retenção, projeto API, perfis BitBrowser, regiões e procedimento de escalonamento. O processo precisa ser compreensível por toda a equipe.
Proveniência e registro das fontes
Um projeto profissional deve guardar não apenas os valores, mas também a origem de cada campo. Registre tipo de fonte, data da consulta, finalidade, identificador do conjunto e eventuais restrições de armazenamento. Isso permite explicar depois se endereço, categoria, coordenadas ou telefone vieram da Places API, do CRM do cliente ou de uma observação manual de QA.
Esse histórico também evita conflitos silenciosos quando várias fontes são combinadas. Um place ID pode ajudar no relacionamento entre registros, mas API e dados próprios têm ciclos de atualização diferentes. Defina prioridade por campo, regra de validação e tratamento de divergências em vez de sobrescrever tudo automaticamente.
Cotas, custos e estratégia de atualização
Ao usar uma API oficial, planeje o custo como parte da arquitetura. Solicite apenas campos necessários para a decisão. Um fluxo em duas etapas — descoberta de candidatos e depois detalhes somente dos locais selecionados — tende a ser mais controlável do que pedir o maior payload possível para cada resultado, principalmente em projetos com muitas cidades.
A frequência de atualização também deve variar por atributo. Categoria e endereço podem mudar lentamente, enquanto horário de funcionamento e status operacional podem exigir revisão mais frequente. Defina refresh por risco de desatualização, valor para o negócio e orçamento, não por uma rotina arbitrária de consultas repetidas.
QA regional reproduzível
Para testar localização, documente cada cenário: cidade ou país alvo, idioma, fuso horário, conexão autorizada, experiência esperada e hipótese que será verificada. Um perfil BitBrowser pode separar a sessão e manter contexto consistente. Ele não deve ser usado para contornar CAPTCHA, rate limits ou outros mecanismos de proteção do Google.
Em cada execução, registre consulta, data e hora, versão do navegador, perfil usado e diferenças observadas. Resultados locais podem variar naturalmente. Um histórico de QA ajuda a distinguir essa variação normal de um problema real de localização, rede ou implementação do seu produto.
Relatórios e entrega para clientes
Em relatórios, diferencie claramente dados da API, observações manuais e dados próprios do cliente. Dizer apenas “extraído do Google Maps” não descreve método, licença nem escopo. Uma seção de metodologia simples aumenta a confiança e ajuda outro analista a reproduzir o estudo mais tarde.
Inclua no pacote final um dicionário de campos, data de atualização, chaves de deduplicação, lacunas conhecidas e limitações. Um CSV enorme sem contexto pode impressionar pelo volume, mas é fraco para decisão. Qualidade exige que o usuário entenda origem, frescor e confiabilidade.
Segurança, papéis e offboarding
Não compartilhe chaves de API, credenciais de proxy ou perfis de navegador em planilhas abertas. Use restrições de chave, contas individuais, menor privilégio e gerenciamento de segredos. Recursos de equipe do BitBrowser podem organizar perfis autorizados, mas a proteção das credenciais precisa continuar em uma camada apropriada de segurança.
Crie também um processo para remoção de acesso. Quando alguém sair do projeto, revogue permissões, rotacione credenciais quando necessário e arquive perfis que não serão mais utilizados. Governança de dados inclui o ciclo completo de acesso, não apenas a fase de coleta ou QA.
Conclusão
Em 2026, Google Maps scraping deve ser tratado como problema de direitos e arquitetura de dados. As regras do Google limitam scraping e reutilização externa.
BitBrowser ajuda a organizar perfis e proxies estáveis para QA regional autorizado. O foco deve ser reprodutibilidade, não bypass. Nessa função, ele complementa bem API e fontes licenciadas.
Perguntas frequentes
Google Maps scraping é permitido?
Os termos atuais incluem uma restrição de scraping de Google Maps Content para uso fora dos Serviços. Revise a versão vigente.
Posso usar Places API?
Sim em muitos casos, respeitando atribuição, armazenamento e usos permitidos.
BitBrowser pode automatizar Maps?
Tem recursos de perfil e API, mas a automação precisa permanecer autorizada.
Proxy serve para resultados locais?
Sim para QA legítimo. Mantenha endpoint estável e não contorne limites.
Quais campos para SEO?
Consulta, região, data, empresa, categoria, site, nota, avaliações visíveis e notas.
place_id pode ser armazenado?
Google possui política específica que permite armazenamento de place_id. Consulte a documentação atual.
E para dataset enorme?
Use fornecedor licenciado de dados empresariais.
Por que BitBrowser?
Para isolar projetos e manter proxy, sessão e configurações regionais consistentes.
Referências oficiais

 Gerenciamento de múltiplas contas
 Prevenir associação de contas
 Gerenciamento multi-funcionário
Recomendados
ver mais