Google Maps Scraping 2026: Daten, Places API und BitBrowser-Workflow
 2026.08.27 15:44
 petro
Google Maps ist für Local SEO, Marktanalysen, Standort-QA und App-Entwicklung äußerst wichtig. Deshalb wird häufig nach “Google Maps Scraping” gesucht. Der Begriff kann jedoch offizielle API-Nutzung, manuelle Browser-Recherche oder das automatisierte Kopieren großer Mengen von Maps-Inhalten in eine externe Datenbank bedeuten.
2026 sollte ein professionelles Projekt mit den Nutzungsbedingungen beginnen. Die aktuellen Google Maps Platform Terms untersagen das Exportieren, Extrahieren oder Scrapen von Google Maps Content zur Nutzung außerhalb der Services und nennen unter anderem das Speichern von Firmennamen, Adressen und Nutzerbewertungen. Daher müssen Zweck, Datenquelle und Aufbewahrungsrecht vor der Technik geklärt werden.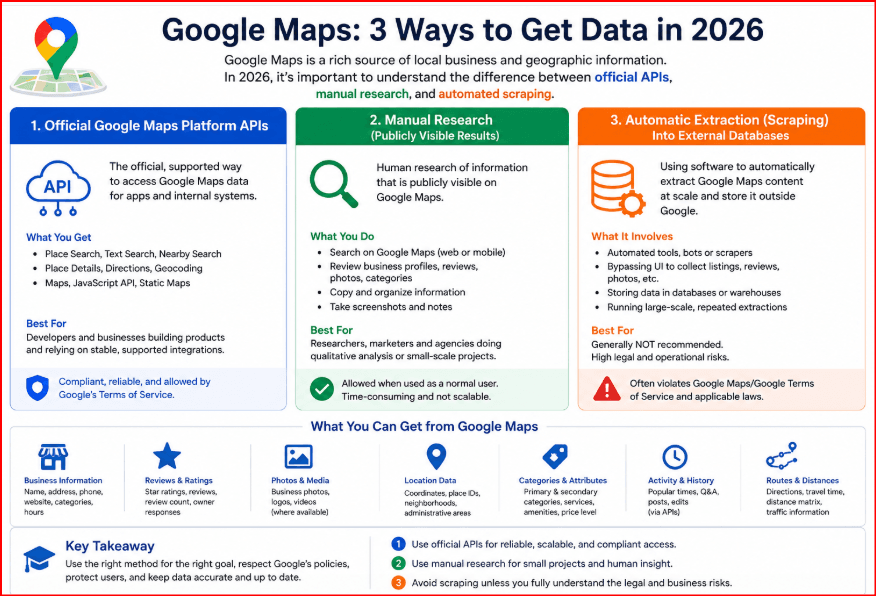
Methodenvergleich
Methode | Am besten für | Speicherung/Rechte | Risiko |
|---|---|---|---|
Places API | Apps und erlaubte Suche | Nach API-Policies | Kosten/Quota |
Manuelles QA | Visuelle Standorttests | Erlaubte Notizen | Kleine Stichprobe |
Lizenzierter Datensatz | Große persistente Analyse | Nach Lizenz | Kosten/Aktualität |
UI-Scraping-Bot | Nicht empfohlen | Konflikt mit No-Scraping | Blocks/Rechte |
Was Google Maps Scraping meist bedeutet
Typische Felder sind Firmenname, Kategorie, Adresse, Telefon, Website, Bewertung, Anzahl der Rezensionen, Öffnungszeiten, Koordinaten oder place_id. Eine kleine manuelle Stichprobe für einen Audit ist etwas anderes als ein Crawler, der Tausende Datensätze dauerhaft speichert.
Für App-Funktionen prüfen Sie Places API. Für große permanente Datenbanken sind lizenzierte Anbieter geeigneter. Für regionale Sichtbarkeitsprüfungen kann ein kontrolliertes Browserprofil sinnvoll sein, ohne daraus eine Massenextraktion zu machen.
Google-Maps-Regeln als Designvorgabe
Die aktuellen Bedingungen enthalten ein ausdrückliches No-Scraping-Verbot. Auch Places API unterliegt Regeln zu Attribution, Caching und Speicherung. place_id wird speziell behandelt, während andere Inhalte nicht als frei speicherbare Datenbank betrachtet werden sollten.
Je nach Service und Abrechnungsregion können zusätzliche Anforderungen gelten. Dokumentieren Sie daher Quelle, Datum, Retention und Attribution jedes Feldes. Diese Provenienz trennt API-Daten von visuellen Browser-Beobachtungen.
Places API und lizenzierte Quellen
Places API bietet strukturierte Antworten, Authentifizierung, Quoten, Billing und Dokumentation. Das ist robuster als das Parsen einer Consumer-Oberfläche und einfacher zu überwachen.
Benötigen Sie Millionen Unternehmen, historische Daten oder Weitergabe, wählen Sie einen Business-Data-Anbieter mit passender Lizenz. API-Zugriff ist keine Erlaubnis für eine unbegrenzte permanente Kopie von Google Maps.
Zuerst ein Datenschema
Ein sinnvolles Schema enthält Suchanfrage, Zielstadt, Datum, Unternehmen, Kategorie, Website, Telefon, sichtbare Bewertung, Rezensionenzahl, Status, place_id soweit erlaubt, Quelle und Notizen.
Ein enges Schema reduziert Kosten und Dubletten. Die Quellen-Spalte trennt API-Daten, manuelle Beobachtung und lizenzierte Drittquellen und macht unterschiedliche Aufbewahrungsregeln sichtbar.
BitBrowser für Google Maps QA
BitBrowser kann autorisierte Standorttests in getrennten Profilen organisieren. Cookies und local storage bleiben isoliert, und pro Profil können HTTP-, HTTPS- oder SOCKS5-Proxys sowie regionale Browserparameter verwendet werden.
Profile wie “Maps QA - Berlin” und “Maps QA - Wien” ermöglichen reproduzierbare Vergleiche. Prüfen Sie die IP vor dem Test und halten Sie den Endpoint stabil. Ziel ist ein konsistenter QA-Kontext, nicht das Umgehen von Schutzmaßnahmen.
Schritt | BitBrowser-Aktion | Zweck |
|---|---|---|
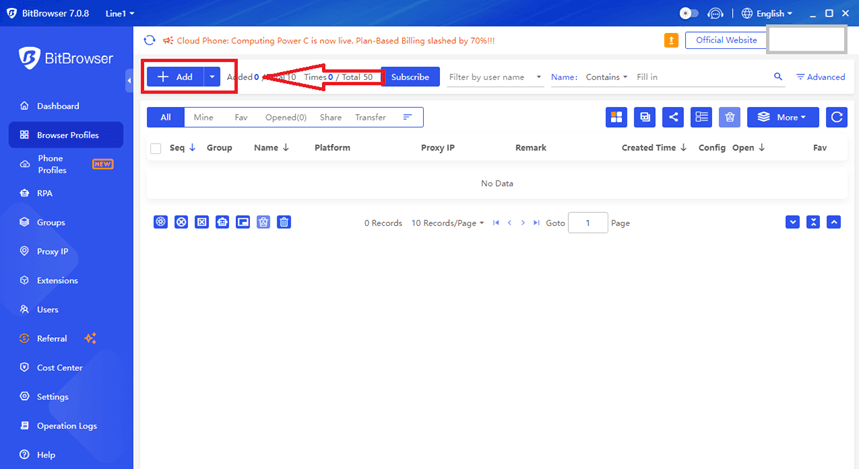
1 | Benanntes Profil erstellen | Kunde/Markt trennen |
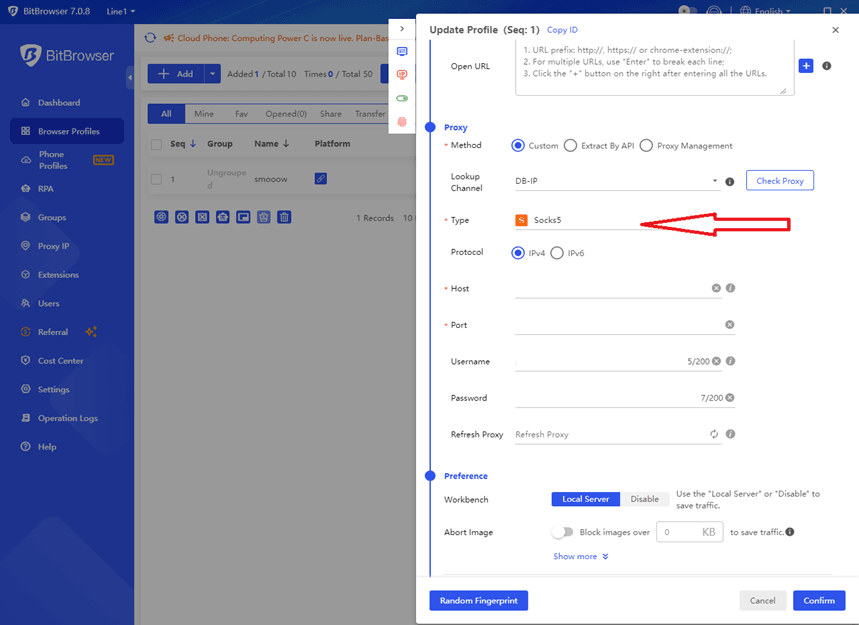
2 | Genehmigten Proxy zuweisen | Netzregion festlegen |
3 | Proxy prüfen | IP bestätigen |
4 | Sprache/Zeitzone anpassen | QA-Kohärenz |
5 | Maps mit festen Queries öffnen | Vergleichbare Beobachtung |
6 | Endpoint stabil halten | Test-Rauschen reduzieren |
7 | Places API für programmatische Daten | QA und Acquisition trennen |
BitBrowser Schritt für Schritt
1. Neues Profil mit eindeutiger Bezeichnung anlegen. 2. Genehmigten Proxy hinzufügen, wenn der Test eine Region benötigt. 3. IP und Erreichbarkeit prüfen. 4. Sprache und Zeitzone passend zum Szenario setzen.
5. Google Maps öffnen und dokumentierte Suchanfragen wiederholen. 6. Nur erforderliche Beobachtungen notieren. 7. Programmatische Place-Daten über Places API oder lizenzierte Quellen beziehen. Keine IP-Rotation zum Umgehen von CAPTCHA oder Limits.
Die richtige Rolle von Proxys
Proxys eignen sich für Standort-QA, Lokalisierung und reproduzierbare Netzwerkbedingungen. Stabilität ist für einen Vergleich wichtiger als häufige Rotation, weil jede Netzwerkänderung zusätzliche Unsicherheit erzeugt.
Ein Proxy verändert keine Nutzungsrechte. Blockierungen sollten zur Neubewertung der Methode führen. Mehr Endpoints lösen weder eine unklare Lizenzsituation noch eine ungeeignete Datenarchitektur.
Local SEO
SEO-Teams können Zusammensetzung lokaler Ergebnisse, Kategorien, Öffnungszeiten, Website-Konsistenz, sichtbare Ratings und Rezensionenzahlen vergleichen. Ergänzen Sie dies mit Google Business Profile, Search Console, Analytics und CRM.
So wird Sichtbarkeit mit tatsächlichem Geschäftserfolg verbunden. Die Browser-Beobachtung zeigt den Kontext, während First-Party-Daten erklären, ob daraus Klicks, Anrufe oder Leads entstehen.
Markt- und Wettbewerbsanalyse
Nutzen Sie repräsentative Suchanfragen und Stadtteile statt einer Vollkopie. Gute Stichproben zeigen Wettbewerb, Kategorien und Online-Präsenz und sind oft ausreichend für strategische Entscheidungen.
Für sehr große Unternehmensmengen ist ein lizenzierter Datensatz nachhaltiger. Er definiert klar, welche Felder gespeichert, aktualisiert oder in internen Analysen verarbeitet werden dürfen.
Datenqualität und Deduplizierung
Firmenbezeichnungen, Telefonnummern und Domains variieren. Normalisieren Sie Formate, behalten Sie aber Rohwerte. Zusammenführen nur anhand ähnlicher Namen ist riskant.
Nutzen Sie Adresse, Telefon, Domain und erlaubte Identifikatoren und dokumentieren Sie Merge-Regeln. Ein Audit Trail macht falsche Zusammenführungen nachvollziehbar und korrigierbar.
Verantwortliche Architektur
Trennen Sie Acquisition, Normalisierung, Storage und Analyse. Quellen können API, Kundendaten, lizenzierte Datensätze und begrenzte manuelle Beobachtungen sein. BitBrowser gehört hauptsächlich in die QA-Schicht.
Das System bleibt damit stabiler bei UI-Änderungen und kann Retention nach Quelle steuern. Browser-Automatisierung sollte nicht unbemerkt zum Ersatz eines autorisierten Datenfeeds werden.
Wann ein Browser-Test besser ist
Manche Fragen sind visuell: welche Kategorien oben erscheinen, ob ein Button sichtbar ist, wie die Oberfläche in einer Sprache wirkt oder ob eine regionale Landingpage korrekt lädt. Dafür sind kontrollierte Profile und Analystennotizen oft besser als große Exporte.
BitBrowser kann denselben Kontext später erneut öffnen. Wenn Profil, Region und genehmigter Proxy stabil bleiben, lassen sich Veränderungen sinnvoller interpretieren.
Praktische Checkliste
Vor jeder Session Forschungsfrage, Region, genehmigte Quelle, Felder, Retention und Verantwortlichen festlegen. Danach BitBrowser-Profil, Endpoint und Suchliste prüfen. Nach dem Test unnötige Beobachtungen entfernen.
Ergänzen Sie Datum und Zweck. Diese kurze Dokumentation verhindert Datensammlung auf Vorrat und verbessert die Nachvollziehbarkeit des fertigen Reports.
Team Governance
Profilverantwortung, Kundengruppen und Namenskonvention definieren. Ein Profil nicht für unabhängige Projekte wiederverwenden. Proxy-Zugangsdaten und API-Schlüssel mit Least Privilege verwalten.
Wenn sich der Projektumfang ändert, Quellen und Retention erneut prüfen. Governance soll verhindern, dass aus einem visuellen QA-Check unbeabsichtigt ein permanenter Datenbestand entsteht.
Häufige Fehler
Nicht zuerst automatisieren und später die Bedingungen lesen. Keine unnötigen Felder sammeln. Provenienz nicht verlieren. CAPTCHA nicht als Aufforderung zu mehr Proxy-Rotation behandeln.
Getrennte BitBrowser-Profile für autorisierte Kundenprojekte verwenden und Sessions nicht unkontrolliert teilen. Isolation verbessert Organisation, ändert aber nicht die Rechte am Inhalt.
Sauber skalieren
Starten Sie mit einem Pilot. Prüfen Sie Nutzen der Felder, Aktualisierungsfrequenz sowie API- oder Lizenzkosten. Oft genügt eine periodische Stichprobe.
Für wiederkehrende Aufgaben empfiehlt sich eine SOP mit erlaubten Quellen, Retention, API-Projekt, BitBrowser-Profilen, Regionen und Eskalationsweg. Der Prozess sollte unabhängig von einer einzelnen Person verständlich bleiben.
Datenherkunft und Provenance dokumentieren
Ein professionelles Local-Data-Projekt speichert nicht nur Werte, sondern auch deren Herkunft. Ergänzen Sie Quelle, Abrufdatum, Verwendungszweck, Datensatz-ID und gegebenenfalls Speicherhinweise. So lässt sich später nachvollziehen, ob eine Adresse, Kategorie, Koordinate oder Telefonnummer aus der Places API, aus dem CRM des Kunden oder aus einer manuellen QA-Beobachtung stammt.
Das ist besonders wichtig, wenn mehrere Quellen zusammengeführt werden. Ein Place ID kann als stabiler Bezugspunkt dienen, doch interne Kundendaten und API-Daten haben unterschiedliche Aktualisierungszyklen. Legen Sie deshalb pro Feld Prioritäten, Validierungsregeln und eine Konfliktbehandlung fest, statt Datensätze blind zu überschreiben.
Quoten, Kosten und Refresh-Strategie
Bei einer offiziellen API-Integration gehört Kostenkontrolle zum Datenmodell. Fordern Sie nur Felder an, die für die jeweilige Entscheidung erforderlich sind. Ein zweistufiges Verfahren — zuerst Kandidaten finden und anschließend Details für ausgewählte Orte abrufen — kann übersichtlicher und wirtschaftlicher sein als für jedes Ergebnis sofort den maximalen Datensatz anzufordern.
Planen Sie außerdem eine sinnvolle Aktualisierung. Eine grundlegende Unternehmenskategorie ändert sich meist seltener als Öffnungszeiten oder ein temporärer Betriebsstatus. Definieren Sie Refresh-Intervalle nach Änderungsrisiko, Geschäftswert und Budget. Mehr Requests sind nicht automatisch gleichbedeutend mit besseren Daten.
Regionale QA reproduzierbar machen
Für Lokalisierungstests sollte jedes Szenario dokumentiert sein: Zielregion, Sprache, Zeitzone, autorisierte Netzwerkverbindung, erwartete Nutzererfahrung und konkrete Prüffrage. Ein BitBrowser-Profil kann diese Testsession isolieren und wiederholbar machen. Es sollte jedoch nicht dazu eingesetzt werden, Captchas, Zugriffsbeschränkungen oder Rate Limits von Google zu umgehen.
Pro Testlauf sollten Suchbegriff, Datum, Uhrzeit, Browser-Version, Profilname und Beobachtung protokolliert werden. Lokale Ergebnisse können sich auch ohne technische Änderung verschieben. Ein Testjournal hilft deshalb, normale Dynamik von einem echten Lokalisierungs-, Netzwerk- oder Produktfehler zu unterscheiden.
Reporting mit Quellenklarheit
Agenturen sollten im Bericht deutlich trennen, welche Aussagen aus der Places API stammen, welche manuell im Browser geprüft wurden und welche aus internen Kundendaten kommen. Die pauschale Formulierung “aus Google Maps gescraped” ist methodisch zu ungenau. Ein nachvollziehbarer Methodenteil macht die Analyse belastbarer und später leichter reproduzierbar.
Zum Export gehören idealerweise ein Datenwörterbuch, Stand der Aktualisierung, Deduplizierungslogik, bekannte Lücken und Nutzungsgrenzen. Ein großer CSV-Download ohne Kontext ist kein hochwertiges Research-Artefakt. Entscheider müssen verstehen können, wie frisch, vollständig und belastbar die einzelnen Felder sind.
Zugriffssicherheit und Offboarding
API-Schlüssel, Proxy-Zugangsdaten und Browserprofile sollten nicht über ungeschützte gemeinsame Dokumente verteilt werden. Nutzen Sie Key-Restrictions, individuelle Rollen, das Least-Privilege-Prinzip und ein geeignetes Secret-Management. BitBrowser-Teamfunktionen können autorisierte Profile organisatorisch trennen, ersetzen aber kein zentrales Sicherheitskonzept.
Definieren Sie zusätzlich einen Offboarding-Prozess: Zugriffe ehemaliger Projektmitglieder entfernen, nicht mehr benötigte Schlüssel rotieren und alte Profile archivieren. Gute Governance deckt den gesamten Lebenszyklus ab — vom ersten Test bis zur Beendigung des Projekts.
Fazit
Google Maps Scraping ist 2026 vor allem ein Thema von Datenrechten und Architektur. Googles aktuelle Regeln beschränken Scraping und externe Wiederverwendung von Maps Content.
BitBrowser unterstützt getrennte Profile und stabile regionale QA-Szenarien. Der Nutzen liegt in Reproduzierbarkeit, nicht im Umgehen von Schutzmaßnahmen. In dieser Rolle ergänzt es API- und lizenzierte Datenquellen sinnvoll.
Häufige Fragen
Ist Google Maps Scraping erlaubt?
Die aktuellen Google Maps Platform Terms enthalten ein No-Scraping-Verbot für Google Maps Content zur Nutzung außerhalb der Services. Prüfen Sie die aktuelle Fassung.
Kann ich Places API nutzen?
Ja, für viele Szenarien. Attribution, Storage und Permitted Use bleiben zu beachten.
Kann BitBrowser Maps automatisieren?
Technisch existieren Profile und APIs, aber Automatisierung muss autorisiert und regelkonform sein.
Sind Proxys für lokale Ergebnisse geeignet?
Für legitimes Standort-QA ja. Endpoint stabil halten und Limits nicht umgehen.
Welche Felder für Local SEO?
Suchanfrage, Region, Datum, Firma, Kategorie, Website, sichtbares Rating, Rezensionenzahl und Notizen.
Darf place_id gespeichert werden?
Google behandelt place_id speziell und erlaubt Speicherung im Rahmen der Policies. Aktuelle Dokumentation prüfen.
Was bei sehr großen Datensätzen?
Einen lizenzierten Business-Data-Anbieter wählen.
Warum BitBrowser?
Zur Projekttrennung und für konsistente regionale Profile mit genehmigten Proxys.
Offizielle Referenzen

 Verwaltung mehrerer Accounts
 Verhindert Account-Verbindung
 Multi-Mitarbeiter-Verwaltung
Empfohlene Artikel
mehr sehen