Google Maps Scraping en 2026 : données, Places API et workflow BitBrowser
 2026.08.27 15:37
 petro
Google Maps est devenu un outil central pour le SEO local, la recherche de marché, le développement d’applications et la vérification de présence locale. La requête “Google Maps scraping” est donc très fréquente. Pourtant, elle peut désigner des méthodes très différentes : interroger une API officielle, observer manuellement des résultats dans un navigateur ou automatiser la copie massive de contenu vers une base externe.
En 2026, la première étape doit être la conformité. Les conditions actuelles de Google Maps Platform interdisent l’exportation, l’extraction ou le scraping de Google Maps Content pour une utilisation en dehors des Services. Google cite notamment la copie et le stockage de noms d’entreprises, d’adresses et d’avis. Un workflow professionnel doit donc définir les données nécessaires, la source autorisée et la durée de conservation.
Comparaison des méthodes
Méthode | Idéal pour | Stockage/droits | Risque |
|---|---|---|---|
Places API | Apps et recherche autorisée | Selon politiques API | Coût/quota |
QA manuel | Tests visuels/localisation | Notes autorisées | Petit échantillon |
Dataset licencié | Analyse persistante large | Selon licence | Coût/fraîcheur |
Bot UI | Non recommandé | Conflit no-scraping | Blocages/droits |
Note de conformité : Google Maps Platform interdit actuellement le scraping de Google Maps Content pour usage hors des Services. Ce guide privilégie Places API, données licenciées et QA contrôlé. N’utilisez pas BitBrowser ou des proxies pour contourner CAPTCHA, quotas ou contrôles. |
Que signifie réellement “Google Maps scraping” ?
Les projets ciblent souvent le nom, la catégorie, l’adresse, le téléphone, le site, la note, le nombre d’avis, les horaires, les coordonnées ou un identifiant de lieu. Une petite observation manuelle pour un audit n’est cependant pas équivalente à un crawler qui copie des milliers de fiches.
Pour une application, étudiez Places API. Pour une base persistante de grande taille, privilégiez une source licenciée. Pour vérifier ce qu’un utilisateur voit depuis une ville donnée, un profil navigateur contrôlé peut servir au QA sans transformer la mission en extraction massive.
Les règles Google Maps à intégrer dès la conception
Les conditions actuelles contiennent une restriction explicite No Scraping. Elles couvrent notamment les téléchargements en masse et la copie de noms, adresses ou avis. Places API possède aussi des exigences de stockage, d’attribution et de cache.
Des différences existent selon le service et la région de facturation, en particulier dans l’EEE. Documentez donc la provenance de chaque champ, sa date de collecte, sa règle de conservation et les obligations d’attribution.
Places API et données sous licence
Places API offre une interface documentée, authentifiée et structurée. Elle est généralement plus stable que le parsing de l’interface grand public et permet de suivre les quotas, les coûts et les erreurs.
L’API n’autorise pas pour autant la création d’une base permanente illimitée. Pour des millions d’entreprises, de l’historique ou de la redistribution, un fournisseur de données commerciales sous licence est souvent plus adapté.
Construire un schéma de données
Un audit local peut utiliser : requête, ville, date, entreprise, catégorie, site, téléphone, note, nombre d’avis, statut d’ouverture, place_id lorsque permis, source et notes. Le champ source est indispensable pour distinguer API, observation manuelle et fournisseur tiers.
Un schéma limité améliore la qualité, diminue les coûts et évite de collecter des informations inutiles. Il facilite aussi la déduplication et l’application de règles de rétention différentes.
Utiliser BitBrowser pour la recherche Google Maps
BitBrowser peut séparer les projets dans des profils isolés avec cookies, stockage local et sessions distinctes. Chaque profil peut utiliser un proxy HTTP, HTTPS ou SOCKS5 autorisé et des paramètres régionaux cohérents.
Créez par exemple “Maps QA - Paris” et “Maps QA - Montréal”. Vérifiez l’IP avant le test et gardez le même endpoint pendant la comparaison. L’objectif est la reproductibilité du scénario, pas le contournement des protections.
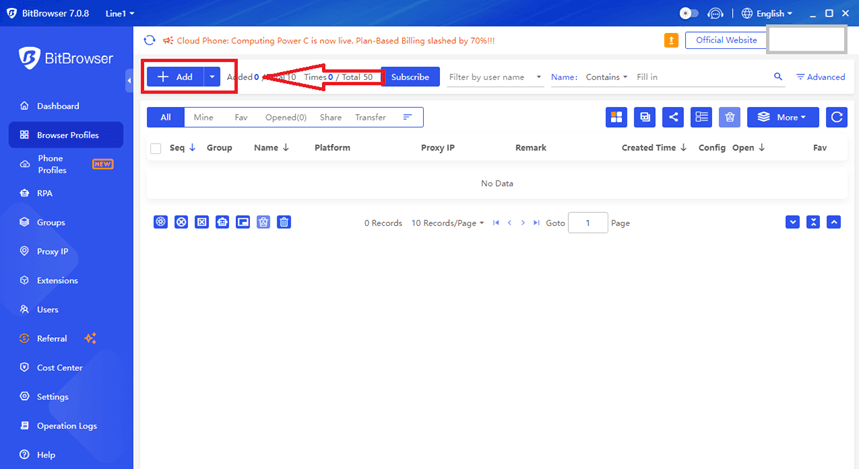
Étape | Action BitBrowser | Objectif |
|---|---|---|
1 | Créer profil nommé | Séparer client/marché |
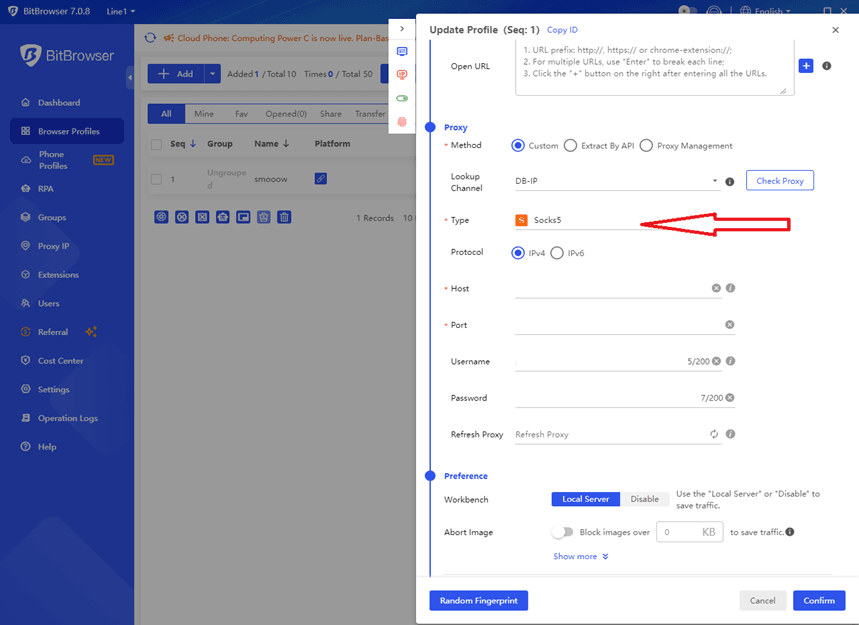
2 | Ajouter proxy approuvé | Définir région réseau |
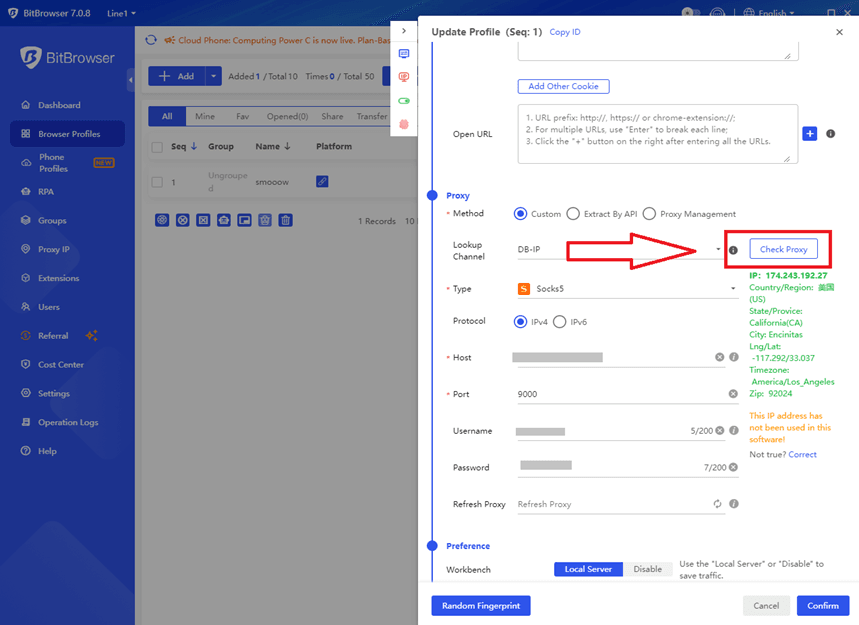
3 | Vérifier proxy | Confirmer IP |
4 | Aligner langue/fuseau | Cohérence QA |
5 | Ouvrir Maps et requêtes fixes | Comparer observations |
6 | Garder endpoint stable | Réduire bruit |
7 | Places API pour données programmatiques | Séparer QA/acquisition |
Workflow BitBrowser étape par étape
1. Créez un profil avec un nom explicite. 2. Ajoutez le proxy approuvé si le test exige une région. 3. Vérifiez IP et disponibilité. 4. Alignez langue et fuseau horaire avec le scénario documenté.
5. Ouvrez Google Maps et répétez les requêtes documentées. 6. Notez uniquement les observations nécessaires. 7. Pour les données programmatiques, utilisez Places API ou une source sous licence. Ne faites pas tourner les IP pour franchir CAPTCHA ou limites.
Le bon rôle des proxies
Un proxy peut simuler un point de sortie réseau utile pour le QA géographique et la localisation. Un endpoint stable permet aux analystes de reproduire le test et de réduire le bruit lié au réseau.
Il ne donne aucun droit supplémentaire sur le contenu. Une limitation ou un CAPTCHA doit conduire à revoir la méthode, la source et l’autorisation, et non à multiplier automatiquement les identités réseau.
SEO local
Les équipes SEO peuvent observer la composition des résultats locaux, les catégories, horaires, liens web, notes et volumes d’avis. Ces observations doivent être combinées avec Google Business Profile, Search Console, analytics, CRM et outils de ranking licenciés.
Cette combinaison relie la visibilité aux conversions réelles et produit une analyse plus utile qu’une copie massive des fiches. Elle aide à distinguer un problème de présence locale d’un problème de conversion sur le site.
Étude de marché et concurrence
Choisissez des requêtes et quartiers représentatifs plutôt que de vouloir capturer toute une ville. Un échantillon bien conçu peut suffire pour comprendre densité, catégories et positionnement.
Pour plusieurs dizaines de milliers d’entreprises, préférez un dataset commercial avec droits explicites. La licence clarifie la conservation, la mise à jour et la possibilité d’utiliser les données dans des analyses internes ou des produits.
Qualité et déduplication
Les noms, téléphones et domaines varient. Normalisez les formats tout en conservant la valeur d’origine. Ne fusionnez pas uniquement sur la similarité du nom.
Croisez adresse, téléphone, domaine et identifiants autorisés. Gardez une trace des règles de fusion afin de pouvoir expliquer ou corriger un regroupement.
Architecture responsable
Séparez acquisition, normalisation, stockage et analyse. Utilisez API, données client, sources licenciées et observations manuelles limitées. BitBrowser se place surtout dans la couche QA.
Cette approche réduit la dépendance à l’interface et permet d’appliquer des politiques de rétention différentes selon la source. Elle simplifie également l’audit des coûts, des quotas et des responsabilités.
Quand le navigateur est préférable
Certaines questions sont visuelles : catégories affichées, présence d’un bouton, rendu selon la langue ou comportement d’une landing page régionale. Dans ces cas, un profil contrôlé avec notes ou captures est plus utile qu’un gros dataset.
BitBrowser permet de réouvrir un contexte comparable avec le même profil, la même région et le même proxy autorisé. Cela aide à interpréter les variations sans multiplier les requêtes automatisées.
Checklist pratique
Avant chaque session, confirmez la question, la région, la source approuvée, les champs, la rétention et le responsable. Vérifiez ensuite profil BitBrowser, endpoint et liste de requêtes. Après la session, supprimez les observations inutiles.
Ajoutez la date, le but de la recherche et la source utilisée. Ce petit contrôle empêche la collecte opportuniste et facilite la relecture du rapport plusieurs semaines plus tard.
Gouvernance équipe
Définissez propriétaires de profils, groupes par client et convention de nommage. Évitez de réutiliser un profil pour des projets sans lien. Protégez credentials proxy et clés API avec le principe du moindre privilège.
Si le périmètre change, réévaluez la source et les règles avant d’augmenter la collecte. Un workflow bien gouverné empêche qu’un simple contrôle visuel devienne par accident une base de données permanente.
Erreurs fréquentes
Automatiser avant de lire les conditions, collecter trop de champs, perdre la provenance ou répondre à chaque CAPTCHA par davantage de proxies sont des erreurs classiques.
Utilisez des profils BitBrowser séparés pour les projets autorisés et limitez le partage de sessions client. Un profil isolé améliore l’organisation mais ne modifie pas les droits applicables au contenu.
Passer à l’échelle proprement
Commencez par un pilote, mesurez l’utilité des champs et la fréquence de mise à jour. Évaluez coût API ou licence. Un échantillon régulier suffit souvent pour une stratégie locale.
Créez une SOP avec sources approuvées, rétention, projet API, profils BitBrowser, régions, requêtes et procédure d’escalade. Le processus doit rester compréhensible même si l’analyste initial quitte le projet.
Conclusion
En 2026, le Google Maps scraping est surtout un sujet de droits d’usage et d’architecture des données. Les conditions Google limitent le scraping et la réutilisation externe du contenu.
BitBrowser peut organiser des profils et proxies stables pour du QA régional autorisé. Sa valeur est la cohérence des tests, pas l’évasion des contrôles. Utilisé ainsi, il renforce la reproductibilité sans devenir un outil de contournement.
Questions fréquentes
Le scraping de Google Maps est-il autorisé ?
Les conditions actuelles de Google Maps Platform interdisent le scraping de Google Maps Content pour usage hors des Services. Vérifiez les conditions applicables.
Puis-je utiliser Places API ?
Oui pour de nombreux scénarios, avec les règles d’attribution, stockage et usage prévues.
BitBrowser peut-il automatiser Google Maps ?
Il peut gérer profils et automatisations, mais uniquement dans un cadre autorisé.
Un proxy permet-il de voir des résultats locaux ?
Oui pour du QA légitime. Gardez un endpoint stable et ne contournez pas les limites.
Quels champs pour un audit SEO ?
Requête, région, date, entreprise, catégorie, site, note et volume d’avis visibles, plus des notes.
Peut-on stocker place_id ?
Google prévoit des règles spécifiques permettant le stockage de place_id. Consultez la politique actuelle.
Que faire pour un très grand dataset ?
Utilisez un fournisseur de données business avec une licence adaptée.
Pourquoi BitBrowser ?
Pour isoler les projets et maintenir proxy, session et paramètres régionaux cohérents.
Références officielles

 Gestion de comptes multiples
 Prévenir l'association de comptes
 Gestion multi-employés
Recommandés
voir plus 
 Comment Accéder à The Pirate Bay en Toute Sécurité en 2026 (Mirrors, Proxys et Risques)
 Top 10 des Meilleures Alternatives à Kickass Torrents en 2026
 Meilleurs bots TikTok de likes en 2025 : augmenter l’engagement et les abonnés en toute sécurité
 Comment résoudre les problèmes de connexion à X (Twitter) en 2026 ? Guide étape par étape