Scraping de Google Maps en 2026: datos, Places API y flujo con BitBrowser
 2026.08.27 15:21
 petro
Google Maps concentra una enorme cantidad de información comercial y geográfica. Equipos de SEO local lo utilizan para estudiar visibilidad, agencias revisan cómo aparecen sus clientes en distintas ciudades y desarrolladores integran búsquedas de lugares mediante Google Maps Platform. Por eso la expresión “scraping de Google Maps” se usa mucho, aunque puede referirse a actividades muy diferentes: consultar la API oficial, realizar investigación manual en el navegador o automatizar la extracción masiva de contenido para guardarlo en una base de datos externa.
En 2026 conviene empezar por la política, no por el bot. Las condiciones actuales de Google Maps Platform prohíben exportar, extraer o hacer scraping del contenido de Google Maps para utilizarlo fuera de los Servicios, e incluyen como ejemplos la descarga masiva de información de lugares y el almacenamiento de nombres, direcciones o reseñas. Un flujo profesional debe definir primero qué datos necesita, qué fuente permite ese uso y cuánto tiempo puede conservarlos.
Comparación de métodos
Método | Mejor para | Almacenamiento/derechos | Riesgo |
|---|---|---|---|
Places API | Apps y búsqueda autorizada | Según políticas API | Coste, cuota, alcance |
QA manual | Pruebas visuales/localización | Notas permitidas | Muestra pequeña |
Dataset con licencia | Análisis masivo persistente | Según licencia | Coste/frescura |
Bot sobre interfaz | No recomendado | Conflicto con no-scraping | Bloqueos y derechos |
Qué significa realmente “scraping de Google Maps”
Normalmente se busca obtener nombre del negocio, categoría, dirección, teléfono, web, puntuación, número de reseñas, horario, coordenadas o un identificador de lugar. El objetivo puede ser SEO local, dimensionamiento de mercado, planificación territorial o control de calidad. Sin embargo, una auditoría manual de una muestra pequeña no es lo mismo que un crawler que copie miles de fichas y mantenga permanentemente el contenido de Google.
Antes de elegir herramientas, crea un esquema de datos y una política de origen. Si necesitas una aplicación con búsqueda de lugares, evalúa Places API. Si necesitas un dataset grande y persistente, busca un proveedor con licencia. Si solo quieres comprobar cómo se muestran resultados en Madrid, Ciudad de México o Buenos Aires, un perfil de navegador controlado puede servir para QA y observación.
Condiciones de Google Maps que debes considerar
Las condiciones vigentes incluyen una restricción explícita de No Scraping. Google indica que no se debe extraer Google Maps Content para usarlo fuera de los Servicios y menciona ejemplos como guardar nombres, direcciones o reseñas. Las políticas de Places API también establecen reglas sobre atribución, almacenamiento y caché. El place_id tiene un tratamiento especial, pero el resto del contenido no debe considerarse una base de datos libre.
Además, existen diferencias según el producto y la región de facturación, especialmente para clientes del EEE. Por eso un proyecto serio documenta la fuente de cada campo, la norma de retención, la fecha de obtención y la atribución necesaria.
Places API y fuentes con licencia
Para muchos casos técnicos, Places API es una alternativa mucho más estable que analizar el HTML de la interfaz de Google Maps. Ofrece autenticación, cuotas, facturación, documentación y campos estructurados. Esto facilita pruebas, control de costes y mantenimiento.
La API no convierte el contenido en datos ilimitadamente reutilizables. Debes respetar sus políticas. Cuando el proyecto exige millones de registros, históricos o redistribución, suele ser mejor contratar una fuente comercial que autorice expresamente ese uso o recopilar información directamente de webs empresariales y fuentes propias.
Diseña primero el esquema de datos
Un buen proyecto puede limitarse a consulta, ciudad objetivo, fecha de observación, nombre del negocio, categoría, web, teléfono visible, rating, número de reseñas, estado de apertura, place_id cuando proceda, fuente y notas. Añade una columna de procedencia para distinguir API, observación manual y proveedor externo.
Con un esquema pequeño se reduce el coste, se mejora la deduplicación y se evita recopilar campos que nadie utilizará. También resulta más fácil justificar por qué se conserva cada dato y aplicar reglas diferentes de retención según la fuente.
Cómo usar BitBrowser para investigación y QA en Google Maps
BitBrowser es útil como capa de organización del navegador para pruebas autorizadas por ubicación. Puedes crear perfiles separados por cliente, ciudad o mercado, mantener cookies y almacenamiento aislados y asignar a cada perfil un proxy HTTP, HTTPS o SOCKS5 aprobado. También puedes ajustar parámetros regionales del navegador para que el escenario de prueba sea coherente.
El objetivo no es ocultar un scraper. El valor está en reproducir entornos: por ejemplo, un perfil “Maps QA - Barcelona” y otro “Maps QA - Bogotá”. Mantén estable el proxy durante la comparación, confirma la IP antes de empezar y registra consulta, fecha, región y cualquier cambio relevante en la sesión.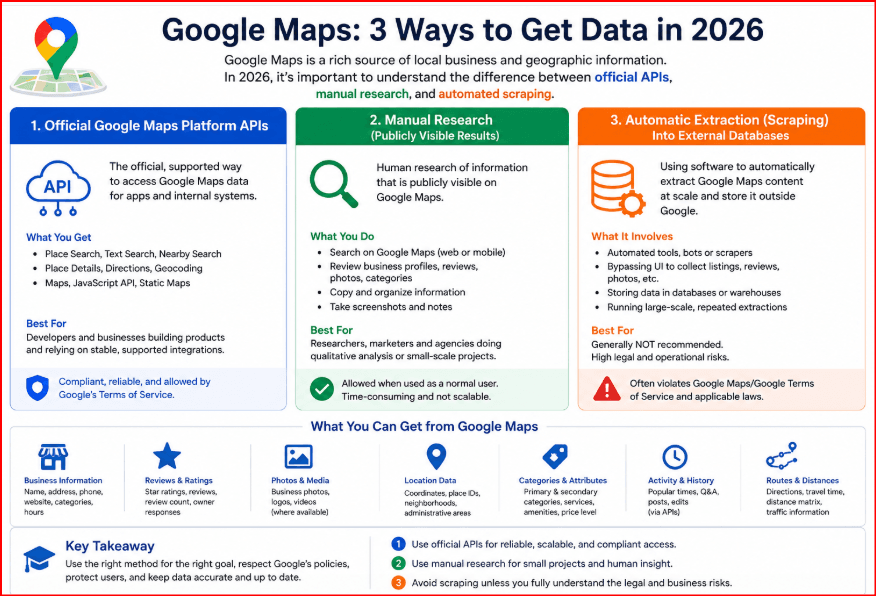
Paso | Acción en BitBrowser | Objetivo |
|---|---|---|
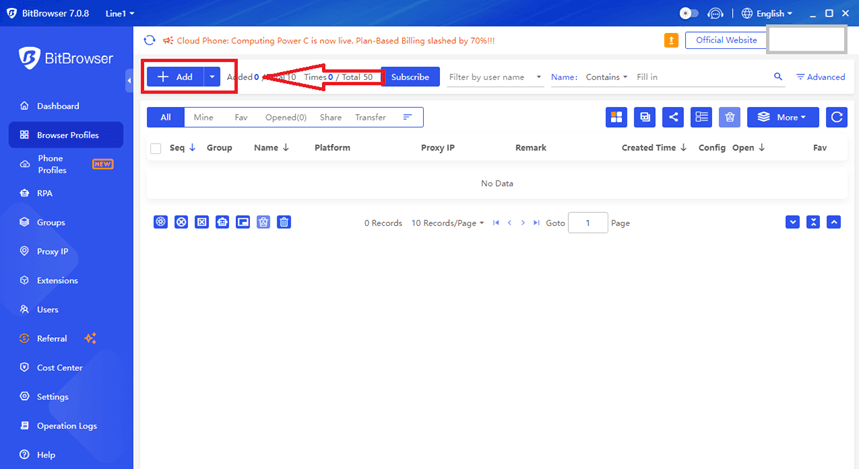
1 | Crear perfil con nombre | Separar sesión por cliente/mercado |
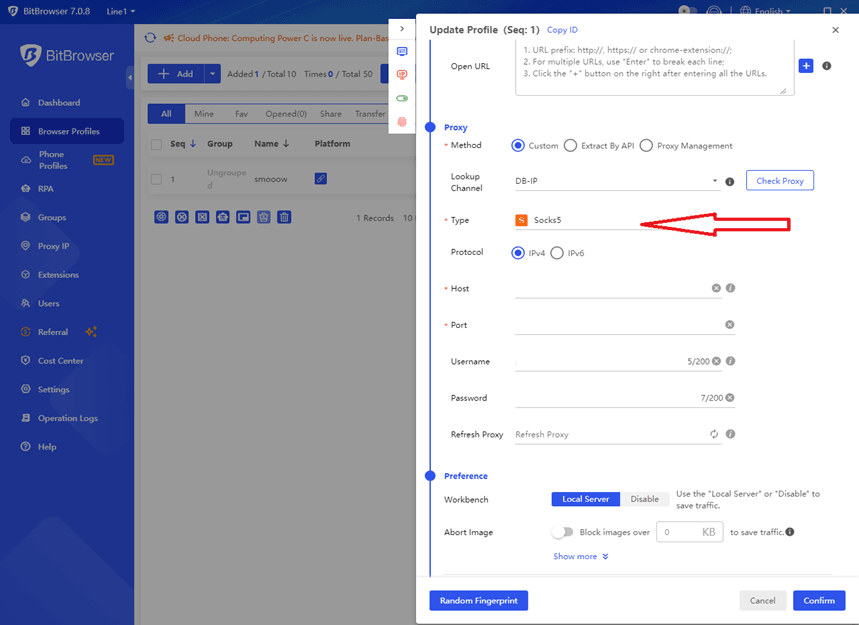
2 | Añadir proxy aprobado | Definir región de red |
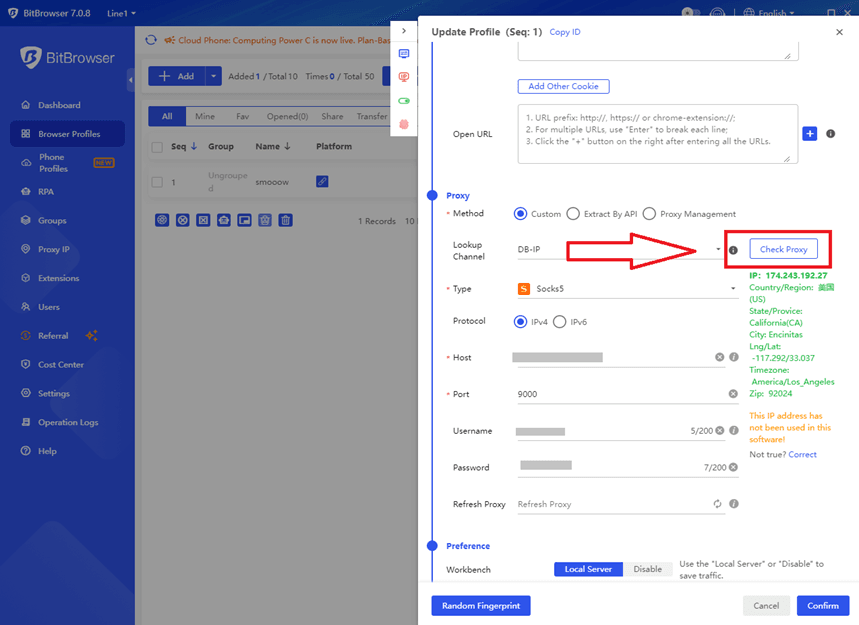
3 | Comprobar proxy | Validar IP |
4 | Alinear idioma/zona | Coherencia regional |
5 | Abrir Maps y usar queries fijas | Comparar observaciones |
6 | Mantener endpoint | Evitar ruido |
7 | Places API para datos programáticos | Separar QA de adquisición |
Flujo paso a paso con BitBrowser
Paso 1: crea un perfil nuevo y ponle un nombre claro. Paso 2: configura el proxy autorizado si necesitas una ubicación de red determinada. Paso 3: utiliza la verificación de proxy para comprobar IP, país y disponibilidad. Paso 4: ajusta idioma y zona horaria de acuerdo con el escenario real de prueba.
Paso 5: abre Google Maps y ejecuta las mismas consultas documentadas. Paso 6: registra solo las observaciones necesarias. Paso 7: si necesitas datos programáticos, realiza esa parte mediante Places API o una fuente con licencia. No utilices rotación de IP para eludir CAPTCHAs, cuotas o controles de la plataforma.
El papel correcto de los proxies
Un proxy cambia el punto de salida de red y puede ayudar a probar experiencias sensibles a la ubicación. Es útil para QA de mercados internacionales, páginas localizadas o presentación regional. También facilita que varios analistas reproduzcan un escenario si usan endpoints estables y documentados.
Un proxy no concede permiso para copiar contenido. Si una automatización encuentra bloqueos o límites, la respuesta profesional es revisar el método y pasar a una API o licencia adecuada, no aumentar la rotación ni intentar disfrazar tráfico automatizado.
Casos de uso para SEO local
Un equipo de SEO local puede estudiar composición del map pack, categorías visibles, consistencia de nombre y web, horarios mostrados y diferencias entre mercados. Después debe combinar esas observaciones con Google Business Profile, Search Console, analítica web, CRM y herramientas de ranking con licencia.
Este enfoque produce mejores decisiones que una tabla masiva porque conecta lo que se ve en Maps con tráfico, llamadas, conversiones y ventas reales. La observación del navegador funciona como evidencia contextual, mientras que las métricas de negocio explican si esa visibilidad genera resultados.
Investigación de competencia y mercado
En lugar de intentar capturar una ciudad completa, selecciona consultas y barrios representativos. Una muestra bien diseñada permite analizar densidad competitiva, categorías y posicionamiento sin recopilar datos indiscriminadamente.
Si el caso de negocio exige miles de empresas, evalúa un dataset comercial. Suele ser más mantenible que luchar contra cambios de interfaz, resolver bloqueos repetidos y mantener datos cuyo derecho de reutilización no está claro.
Calidad, deduplicación y normalización
Los negocios pueden aparecer con variantes de nombre, teléfonos diferentes, redirecciones web y sucursales similares. Normaliza dominios y teléfonos, conserva el valor original y registra las reglas utilizadas para fusionar registros.
No deduzcas que dos fichas son iguales solo por su nombre. Utiliza dirección, dominio, teléfono e identificadores permitidos. Mantén un historial de decisiones para que el análisis sea auditable y pueda corregirse si una regla de normalización produce falsos positivos.
Arquitectura de automatización responsable
Separa adquisición, normalización, almacenamiento y análisis. En adquisición utiliza APIs, datos propios, proveedores con licencia y observaciones manuales limitadas. En almacenamiento aplica reglas diferentes según la fuente. BitBrowser pertenece principalmente a la capa de QA del navegador.
Esta arquitectura resiste mejor los cambios de interfaz y permite controlar costes, cuotas y permisos. También evita que un script de navegador termine convertido accidentalmente en la fuente principal de un producto que requiere datos persistentes.
Cuándo una prueba de navegador es mejor que un dataset
Algunas preguntas son visuales: qué categorías aparecen primero, cómo se muestra un botón, si una landing regional funciona, si cambia la presentación por idioma o qué elementos son visibles en una ficha. En esos casos un perfil controlado y notas del analista pueden ser más útiles que una gran base extraída.
BitBrowser facilita repetir ese contexto con el mismo perfil, región, idioma y proxy aprobado. De esta manera puedes comparar una experiencia a lo largo del tiempo sin convertir la tarea de QA en una operación de extracción masiva.
Checklist práctico de investigación
Antes de cada sesión confirma objetivo, región, fuente autorizada, campos, retención y responsable. Después valida el perfil BitBrowser, el endpoint de red y las consultas. Al terminar elimina observaciones innecesarias y conserva únicamente lo que el proyecto puede guardar.
Este procedimiento sencillo obliga a responder primero la pregunta de negocio y evita que el equipo recopile datos “por si acaso”. También deja una pista clara sobre cuándo se hizo la observación y qué configuración se utilizó.
Gobernanza de equipo
En agencias conviene asignar propietarios de perfiles, grupos por cliente y reglas de nombres. No reutilices un perfil para proyectos sin relación y revisa credenciales de proxy periódicamente. Si existe automatización con API, aplica mínimo privilegio y separa las claves de los datos de navegación.
Los miembros del equipo deben saber qué perfiles están autorizados, qué datos pueden conservarse y cuándo un cambio en el alcance necesita revisión de privacidad o de términos de plataforma. Una buena gobernanza reduce errores y protege sesiones sensibles de clientes.
Errores frecuentes
Un error común es automatizar antes de leer las condiciones. Otro es recopilar todos los campos disponibles, aunque el informe solo use cinco. También es problemático mezclar datos de API, navegador y terceros sin conservar la procedencia.
No uses proxies rotativos como respuesta automática a un CAPTCHA. No compartas una única sesión de cliente entre todo el equipo. Usa perfiles BitBrowser separados para proyectos autorizados y no prometas que una configuración hace “indetectable” o permitido un método de extracción.
Cómo escalar sin perder control
Empieza con un piloto y comprueba si los campos seleccionados responden a la pregunta de negocio. Calcula frecuencia de actualización y coste de API o licencia. Muchas estrategias de SEO solo requieren una muestra periódica, no un espejo permanente de Google Maps.
Para trabajos recurrentes crea un SOP con fuentes permitidas, retención, propietario del proceso, perfiles BitBrowser autorizados, consultas, regiones y procedimiento de escalado cuando cambie la plataforma o aparezca un bloqueo.
Conclusión
En 2026, “Google Maps scraping” debería entenderse como un problema de adquisición de datos y cumplimiento, no simplemente como un reto técnico. Las condiciones actuales de Google restringen el scraping y la reutilización externa de Google Maps Content. Places API, fuentes con licencia y datos propios suelen ser opciones más sólidas.
BitBrowser aporta valor para organizar perfiles, proxies y configuraciones regionales durante pruebas manuales y QA. Utilizado así, mejora la reproducibilidad sin convertir el navegador en una herramienta para eludir controles. El resultado es un flujo más fácil de mantener y explicar a clientes.
Preguntas frecuentes
¿Está permitido hacer scraping de Google Maps?
Las condiciones actuales de Google Maps Platform incluyen una prohibición de scraping del contenido para uso fuera de los Servicios. Revisa siempre la versión vigente aplicable a tu cuenta y región.
¿Puedo usar Places API?
Sí, para muchos casos es la ruta programática recomendada. Aun así, existen reglas de atribución, almacenamiento y uso.
¿BitBrowser puede automatizar Google Maps?
BitBrowser dispone de perfiles y APIs de automatización, pero la capacidad técnica no cambia los permisos de uso. Úsalo para QA y procesos autorizados.
¿Puedo usar proxies para resultados locales?
Sí, en pruebas legítimas de ubicación. Mantén endpoints estables y no los uses para eludir límites o CAPTCHA.
¿Qué campos conviene registrar?
Solo los necesarios para el objetivo: consulta, región, fecha, identidad, categoría, web, rating y reseñas visibles, y notas.
¿Se puede guardar place_id?
Google permite almacenar place_id bajo sus políticas específicas. Comprueba siempre la documentación vigente.
¿Qué hago si necesito millones de registros?
Busca un proveedor de datos empresariales con licencia para almacenamiento y análisis a gran escala.
¿Por qué usar BitBrowser?
Para separar proyectos, asociar proxies aprobados y conservar sesiones y ajustes regionales reproducibles.
Referencias oficiales

 Multi-Account Management
 Prevent Account Association
 Multi-Employee Management
Recommended
See More